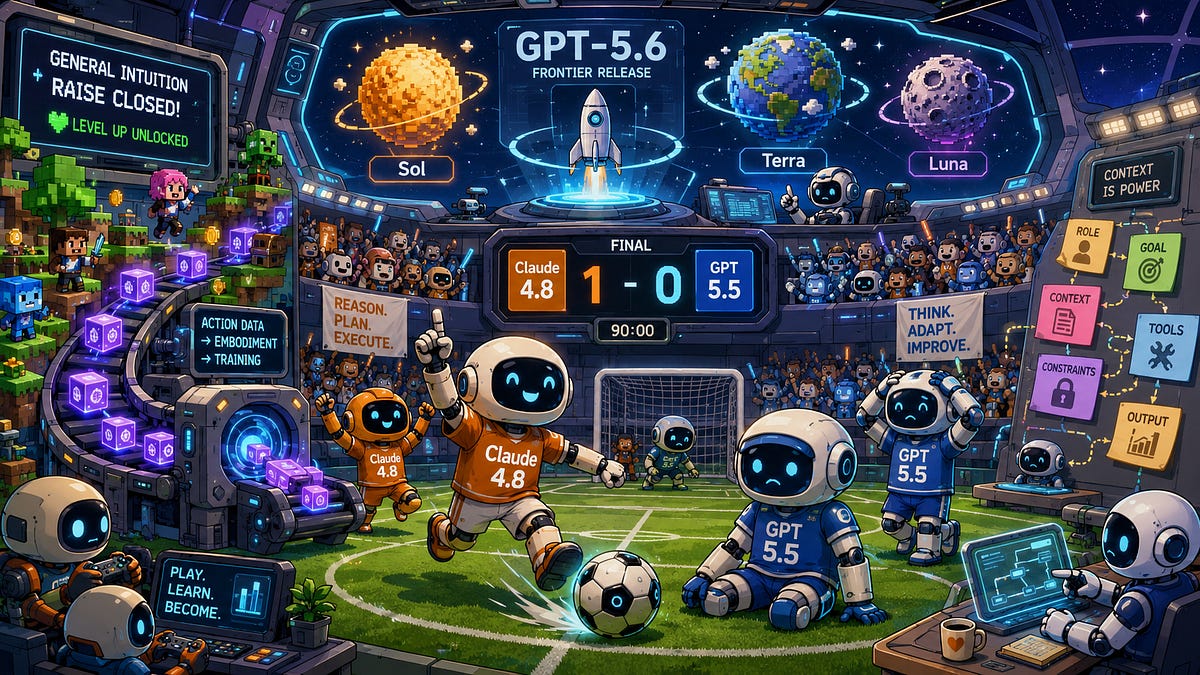
На прошлой неделе OpenAI выпустила пакет моделей GPT-5.6, Anthropic представила функцию Claude Tag, а General Intuition продвигает использование видеоигр для обучения ИИ. Кубок LayerLens Stratix стал испытанием моделей в игровой среде. Кроме того, ряд компаний и исследовательских групп представили новые разработки и привлекли финансирование.
Разработан трёхэтапный метод обучения агентов LLM для более точного прогнозирования последствий действий — он эффективнее базовых подходов в задачах поиска и математического анализа.
В Deep Agents внедрены динамические субагенты, которые помогают агентам решать масштабные задачи за счёт программной оркестровки: вместо прямых вызовов инструментов агент пишет скрипт для организации работы субагентов. Механизм обеспечивает детерминированный охват и надёжную оркестровку сложных процессов. В материале описаны практические сценарии использования и шаблоны оркестровки.
Учёные выяснили, что личностные черты LLM по‑разному влияют на работу мультиагентных команд в зависимости от типа задачи — от незначительного эффекта в кодировании до сильного снижения производительности в переговорах и сотрудничестве.
Платформа OverFlowLight в реальном времени обнаруживает заторы и корректирует работу светофоров, снижая количество инцидентов с переполнением на 60,4% и увеличивая пропускную способность сети на 18,2%.
LangChain представила обновления LangSmith, включая новые шаблоны агентов и интерфейсы для работы с аудио и трассировкой. Запущен курс по развёртыванию LangSmith и учебное пособие по добавлению голоса в LangGraph Agents. Анонсированы мероприятия в разных городах в июне–августе 2026 года.
Команда сократила расходы на ИИ за счёт маршрутизации запросов между дешёвой и дорогой моделями, но через несколько месяцев заметила падение удовлетворённости клиентов и рост оттока. Проблема в том, что существующая система измерений не позволяла отследить разрыв в качестве на разных уровнях маршрутизации. В качестве решения предложен каскадный подход к обработке запросов.
ProfileFoundry — генератор синтетических данных для оценки работы LLM-агентов: память, конфиденциальность, работа с документами. 100 тыс. профилей, более 700 тыс. событий.
Платформа RQGM позволяет ИИ‑агентам эффективнее самосовершенствоваться за счёт динамической смены критериев оценки. Показала лучшие результаты в кодировании, написании и рецензировании статей и др.