Новый фильтр Калмана: агенты смогут точнее оценивать данные в сложных условиях
Создан новый фильтр Калмана (CA-NKCF) для распределённой оценки данных: он эффективнее аналогов и не требует точных данных о шуме, хорошо работает в сложных условиях.
561 статьи по теме
Создан новый фильтр Калмана (CA-NKCF) для распределённой оценки данных: он эффективнее аналогов и не требует точных данных о шуме, хорошо работает в сложных условиях.
Разработан метод автоматического извлечения лексической информации из словаря Al‑Mawrid с помощью n‑граммового анализа, KWIC и правил; показана высокая точность извлечения разных типов данных.
Разработан неконтролируемый метод распознавания действий по данным IMU с использованием автоэнкодера и LSTM; точность на DaLiAc и PAMAP2 — 96,6% и 98,4%.
Учёные разработали модель генерации текста, которая допускает ошибки, но сохраняет высокую точность; подход приближает ИИ к реальным условиям работы с языком.
Представлен тест SciDraw-Bench для оценки научных рисунков, сгенерированных ИИ. Он проверяет корректность надписей, изображений и соблюдение правил. Система SciDraw AI лучше общих моделей.
Разработан замкнутый цикл обработки данных для выявления и устранения слабых мест в LLM; метод протестирован на задачах BBH и AIME2025/AIME2026, показал эффективность.
Разработан агент RSEA, который самостоятельно улучшает свою работу и безопасно адаптируется к задачам. В тестах показал высокие результаты.
Институт Шанчжи, Шанхайский университет науки и технологии и Фуданьский университет представили фреймворк FLAG для восстановления структуры пространственного транскриптома. Модель переопределяет задачу с детерминированной регрессии на моделирование структурированного распределения и успешно справляется с «проклятием генетической размерности». Эксперименты показали преимущество FLAG по структурным показателям в сравнении с другими методами.
Yuvion LLM — модель ИИ с усиленной защитой от угроз, учитывающая «состязательный» характер атак; в тестах превзошла GPT-5.4 и Qwen3-MAX по показателям безопасности.
QDiffusion-TS — квантовая модель для синтеза временных рядов: сокращает число параметров и точнее генерирует данные, чем классические аналоги.
LaViD — платформа для передачи знаний от LLM к моделям компьютерного зрения. Превосходит существующие методы, повышает точность распознавания объектов.
Создан тест NormAct для оценки способности MLLM учитывать скрытые социальные нормы; предложен NormPerceptor, повышающий успешность задач с 24,2% до 46,7%.
Алгоритм ATOD объединяет OPD и RL для обучения автономных агентов; показал лучшие результаты в тестах на ALFWorld, WebShop и Search-QA.
Техническая команда Kuaishou представит ряд исследований на ICML 2026. Работы охватывают ключевые направления ИИ, включая большие языковые модели, обучение с подкреплением и компьютерное зрение. Конференция пройдёт с 6 по 11 июля в Сеуле.
Ли Донхао основал бренд AIVELA, который стремится занять нишу на рынке носимых устройств с ИИ. AIVELA Ring Pro отличается расширенным функционалом и новым подходом к взаимодействию с пользователем — в отличие от «строгого» стиля Oura, AIVELA использует «материнский» подход. Рынок смарт-колец демонстрирует высокие темпы роста, и AIVELA нацелена занять свою нишу, опираясь на возможности ИИ.
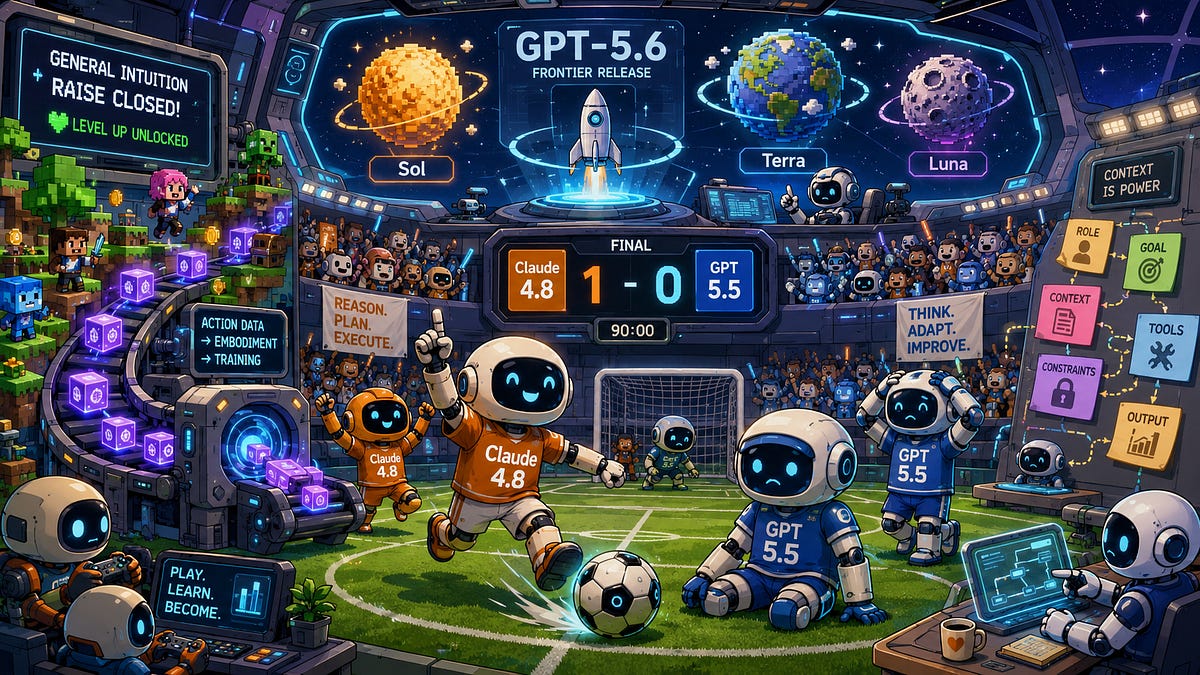
На прошлой неделе OpenAI выпустила пакет моделей GPT-5.6, Anthropic представила функцию Claude Tag, а General Intuition продвигает использование видеоигр для обучения ИИ. Кубок LayerLens Stratix стал испытанием моделей в игровой среде. Кроме того, ряд компаний и исследовательских групп представили новые разработки и привлекли финансирование.
Разработан трёхэтапный метод обучения агентов LLM для более точного прогнозирования последствий действий — он эффективнее базовых подходов в задачах поиска и математического анализа.
GILP уменьшает галлюцинации в LLM, объединяя параметризованную модель и рассуждения агента через API; частота ошибок снизилась в 5 раз.
Выявлена проблема использования устаревшей информации агентами LLM в диалогах. Создана среда Supersede для обучения моделей работать с актуальными данными — точность ответов выросла почти вдвое.
Учёные выяснили, что трансформеры сначала усваивают общие языковые правила, а затем — локальные зависимости; предложена новая концепция обучения NLM.