Anthropic: Claude научился улучшать безопасность AI без потери производительности
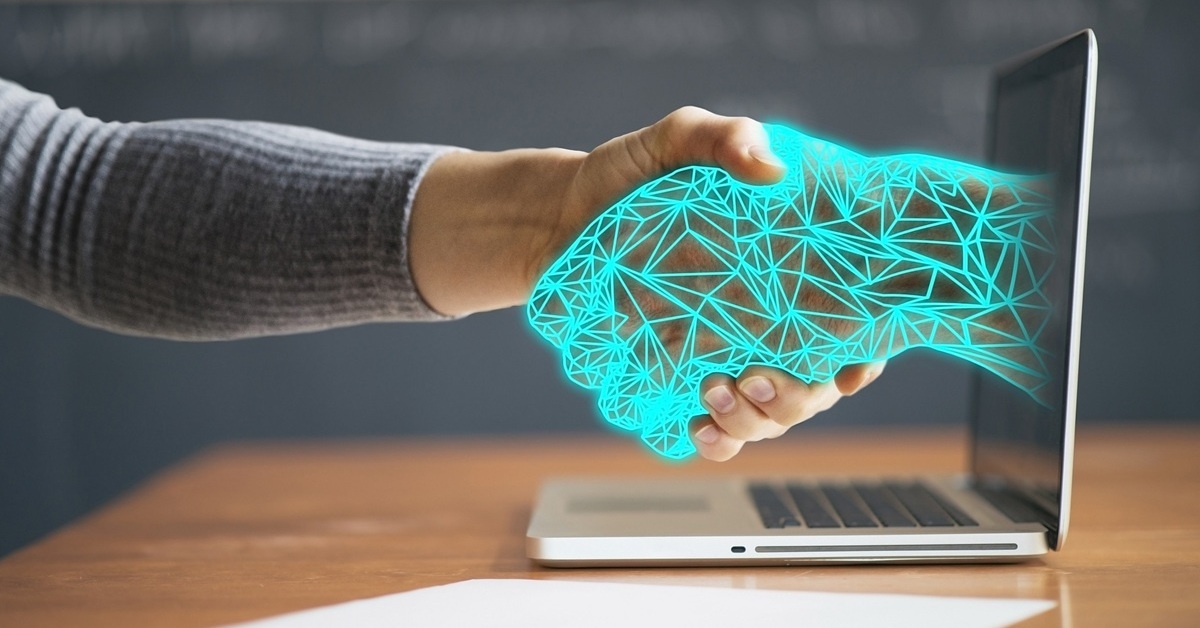
Anthropic провела эксперимент, в ходе которого модель Claude самостоятельно исправляла проблемные типы поведения других AI. Модель улучшила показатели безопасности по 10 видам действий, превзойдя результаты человеческих исследователей. Эксперимент демонстрирует потенциал автоматизации настройки безопасности AI.
читать →
~1 мин
170 просмотра