Платформа Hugging Face выпустила открытую модель Carbon-X, которая позволяет исследователям работать с ДНК-последовательностями через естественный язык — задавать вопросы и получать интерпретации, прогнозы и пояснения. Модель разработана совместно с Zhongguancun Academy, Telethon Institute of Genetics and Medicine (Италия) и University of Naples Federico II.
Carbon-X имеет 148 млрд параметров, базируется на Qwen3-14B от Alibaba и обучена на данных о ДНК человека, млекопитающих, растений и грибов. Модель использует смешанный токенизатор: для текста применяется привычный словарь, а ДНК кодируется группами по 6 оснований. Сначала модель прошла промежуточное обучение на 3,02 трлн токенов (ДНК, биологические тексты, английские тексты и инструкции), затем — контролируемую доработку и обучение с подкреплением.
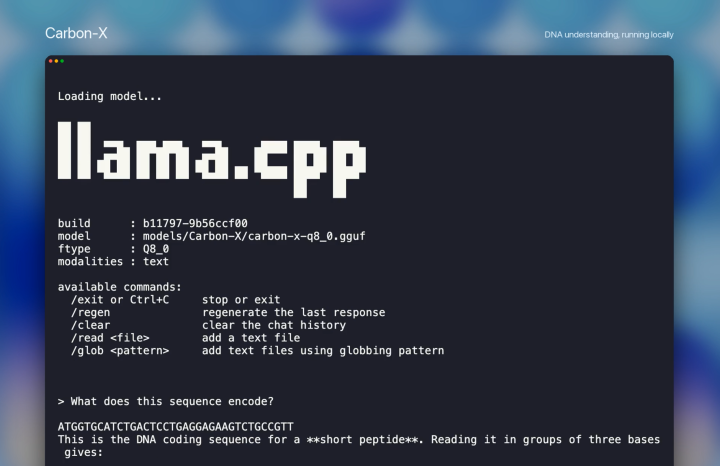
С помощью Carbon-X можно, например, определить, является ли мутация доброкачественной или патогенной, распознать области активности регуляторных генов, классифицировать последовательности по видам, предсказать следующие основания в последовательности и объяснить логику рассуждений. Например, исследователь может предоставить последовательность ДНК и спросить, повышает ли конкретная мутация риск заболевания — модель выдаст прогноз и объяснение.
В ходе пяти тестов Carbon-X показала средний результат 66,7 %. Это на 27 процентных пунктов выше, чем у Qwen3-14B, и близко к результату GPT-6.1 Sol (67,5 %), при этом стоимость рассуждений примерно в 1800 раз ниже. Модель лучше всех протестированных показала себя в прогнозировании эффекта вариаций в кодирующих белки областях и предсказании следующего основания. Однако в тестах на вставки и удаления (неоднонуклеотидные вариации) результат Carbon-X (85,1 %) уступает GPT-6.1 Sol, Opus 5.5 от Anthropic и Gemini 4 Argon от Google.
Анализ примерно 2,4 млн неопределённых генетических вариаций из базы ClinVar с помощью Carbon-X обойдётся примерно в 300 долларов, тогда как для других передовых моделей стоимость составит от 32 тыс. до 4 млн долларов.
Модель распространяется по лицензии Apache 2.0: её можно загрузить через инструмент Transformers или развернуть с помощью фреймворка vLLM. Модель с точностью BF16 может работать на одном GPU с 80 ГБ памяти. Исследователи могут обрабатывать чувствительные или ещё не опубликованные последовательности на собственных вычислительных ресурсах, не делясь данными с внешними компаниями.
При этом модель ещё не прошла клинические испытания и не может использоваться для принятия медицинских решений. Среди ограничений — возможные ошибки в подсчёте оснований, путаница с координатами, сложности с точным определением позиций в длинных последовательностях, снижение качества при генерации длинных ДНК-последовательностей. В некоторых задачах (например, связанных с сайтами сплайсинга или гистоновыми метками) результаты модели довольно низкие — 29,8 % и 34,6 % соответственно.
Льюис Танстолл из Hugging Face отмечает, что цель создания Carbon-X — дать исследователям альтернативу зависимости от крупных AI-лабораторий. В перспективе модель может стать шагом к персонализированной медицине — когда на основе генома и истории болезни человека будут подбирать индивидуальное лечение.
 Подписаться в Макс
