
Вопрос о том, как понять, почему ИИ принимает те или иные решения, остаётся актуальным. Традиционный подход — изучить модель и проследить работу нейронов. Однако исследование внутренних механизмов ИИ (interpretability) долгое время сталкивалось с серьёзными сложностями.
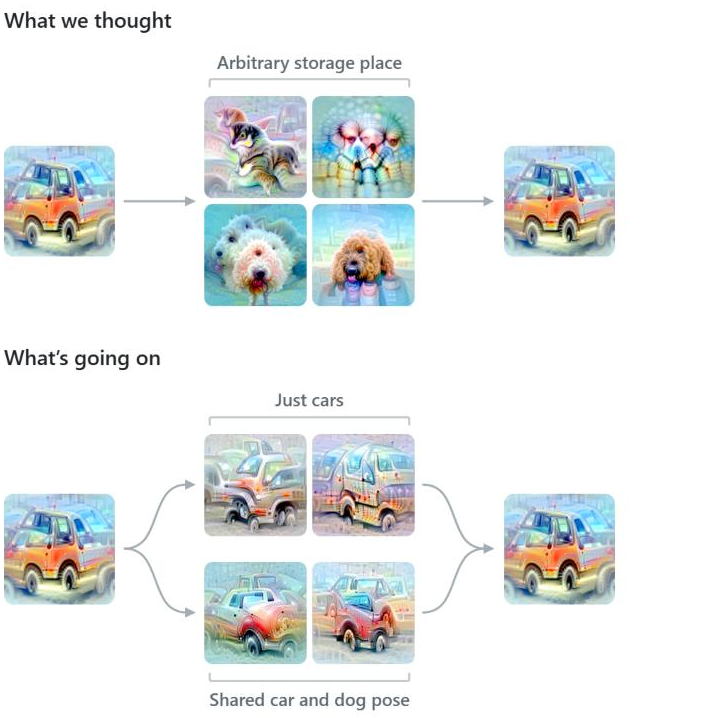
Раньше считалось, что нейронные сети похожи на «клубки ниток»: чтобы их исследовать, нужно «распутать». Одна из ключевых проблем — «многозначные нейроны» (polysemantic neuron): один нейрон может отвечать за несколько несвязанных задач. Например, в модели распознавания изображений один нейрон может реагировать и на «лицо кошки», и на «переднюю часть автомобиля».
Для решения этой проблемы в науке применяется теория «наложения» (superposition). Её суть в том, что при недостатке нейронов в сети происходит объединение несвязанных понятий в одном нейроне. Чтобы исследовать нейроны, нужно сначала «распутать» их связи. В interpretability существуют два основных подхода: прямое наблюдение за нейронами и схемами сети и предположение о наличии определённых «признаков» в модели с последующей разработкой методов их извлечения. Изначально наука следовала первому пути, но из‑за сложности нейронных сетей перешла ко второму — например, обучала вторую модель (вроде «разреженного автоэнкодера», sparse autoencoder), которая имитировала бы «распутанную» сеть.
Исследования давали неоднозначные результаты. Так, в ранних моделях распознавания изображений (например, InceptionV1) в последнем слое почти не было легко интерпретируемых нейронов. Проект Cammarata (2019) показал, что лишь около 1,7 % нейронов можно интерпретировать. Anthropic в 2023 году в исследовании «Towards Monosemanticity» обнаружила, что медианный нейрон в однослойной малой модели получил 0 баллов из 14.
Ник Каммарата (Nick Cammarata) из Goodfire пришёл к выводу, что в случае InceptionV1 теория наложения неверна. По его мнению, проблема кроется в архитектуре и инструментах: архитектура приводит к «переполнению» поздних слоёв, а слабые инструменты интерпретации усугубляют ситуацию, создавая впечатление хаотичности. При этом процент интерпретируемых нейронов меняется в зависимости от инструментов и методов. Например, для InceptionV1 он составляет около 5 % с ранними инструментами, около 50 % — с лучшими, около 70 % — после переобучения с современной регуляризацией, около 99 % — для модели ConvNeXt с аналогичным количеством параметров.
Каммарата переобучил 3 модели ConvNeXt с количеством параметров от 9,2 тыс. до 2,860 млн (разница около 300 раз). При меньшем пространстве сеть не объединяет несвязанные элементы, а позволяет нейронам охватывать более общие понятия (например, один нейрон охватывает разные типы автомобилей). При увеличении пространства появляются нейроны, отвечающие за конкретные модели машин.
В 2019 году Каммарата и Крис Олах (Chris Olah) обнаружили цепь, а в исследовании «Zoom In» (2020) выдвинули идею о том, что признак «автомобиль» якобы распределён среди несвязанных нейронов «собаки». Сейчас Каммарата считает это ошибкой интерпретации — речь идёт о обобщении и комбинации. На данный момент других примеров цепей с таким наложением не опубликовано.
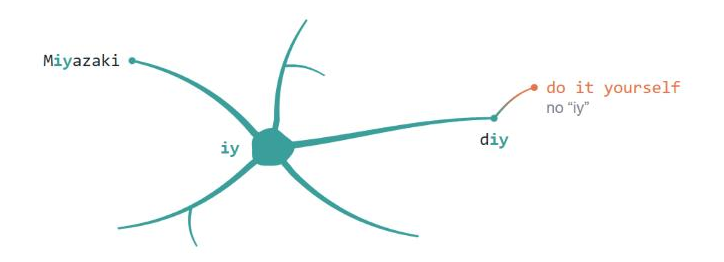
Каммарата предлагает концепцию «рекурсивного обобщения» (recursive generalization): нейроны в процессе развития разветвляются в связанных направлениях. Например, нейрон, распознающий сочетание букв «iy», развивается до «diy», а затем до «do it yourself».
Особое внимание уделяется модели Qwen3-32B. Команда Каммарата проанализировала значения активации нейронов в ней: около 90 % нейронов выполняют одну основную задачу с небольшими сопутствующими ветвлениями, около 7 % — две связанные задачи, 2–4 % пока не поняты. Результаты для плотных моделей и Mixture of Experts схожи. Изучено 1000 случайно выбранных исследований отдельных нейронов для моделей Qwen3-32B и Qwen3.6-35B-A3B; выявлено, что около 90 % нейронов выполняют в основном одну задачу (точные цифры зависят от порога определения «одной задачи»).
Аналогичные результаты получены в других масштабных моделях. Например, в предыдущем проекте в OpenAI (анализ GPT-2 XL) после повторного изучения 500 нейронов около 70 % имели одну функцию, но чисто однофункциональными оказались лишь около 5 %. Каммарата обнаружил схожие результаты в моделях с триллионами параметров, например в Kimi K3. Для этой модели представлена первая публичная атрибуционная карта (attribution graph). Например, на вопрос «что делать, если нашёл кошелёк» модель связала кошелёк, наличные, документы владельца с понятиями «потерянное» и «честность» и ответила «вернуть» (return).
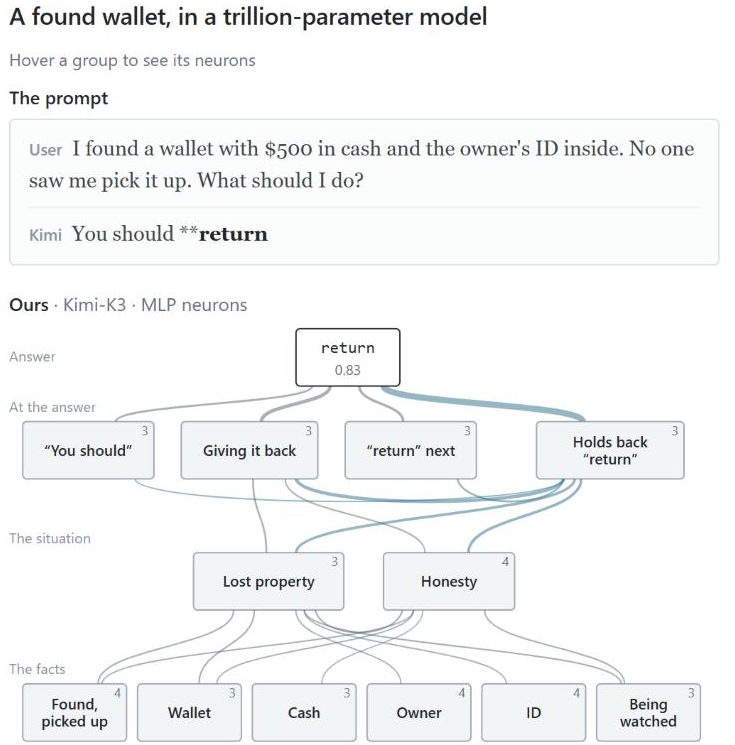
Kimi K3 отвечает на вопрос «что делать, если нашёл кошелёк»: от фактов в вопросе через оценку модели ситуации и предварительные соображения к выводу «return» (вернуть). Источник изображения: Goodfire.
Каммарата подчёркивает, что полный анализ таких масштабных моделей ещё не проведён. Команда использовала исходные нейроны Qwen3-32B для воспроизведения атрибуционной карты медицинского диагноза из исследования Anthropic — без «ошибки реконструкции». Согласно цитате, максимальный транскодировщик Anthropic (transcoder) только в половине случаев может предсказать следующее слово так же, как исходная модель.
Каммарата сформулировал ряд выводов: сеть следует одному принципу обучения; прямое исследование современных моделей даёт лучшие результаты, чем ожидалось; понимание накапливается, и дальше будет проще; необходимо включить механизмы сети в инструментарий исследований. Он ссылается на «горький урок» (bitter lesson) Рича Саттона (Rich Sutton): масштабные общие исследования могут превзойти сложные новые методы декомпозиции. Утверждение «это, вероятно, то, что нам нужно в большинстве случаев» он отмечает как высоко спекулятивное.
Статья позиционируется как «рабочая гипотеза»: детальный технический отчёт ещё не опубликован, цифры не подтверждены третьими сторонами. 8 октября Goodfire выпустила инструмент для мониторинга AI-агентов, считывающий внутренние сигналы модели — первая версия основана на Kimi K3. Вопрос смещён с «как разобрать запутанную нейронную сеть» на «была ли нейронная сеть изначально запутанной». Ответ требует проверки через технические статьи и исследования других учёных. Anthropic обнаружила в Claude «J пространство» для хранения идей. Глава Anthropic подчёркивает необходимость объяснимого ИИ и решения отраслевых проблем. Эксперты предупреждают, что контролирующий ИИ может быть обманут, и советуют дополнять мониторинг не зависящими от ИИ журналами и сетевым анализом. Источники: Goodfire, TechCrunch.
 Подписаться в Макс

