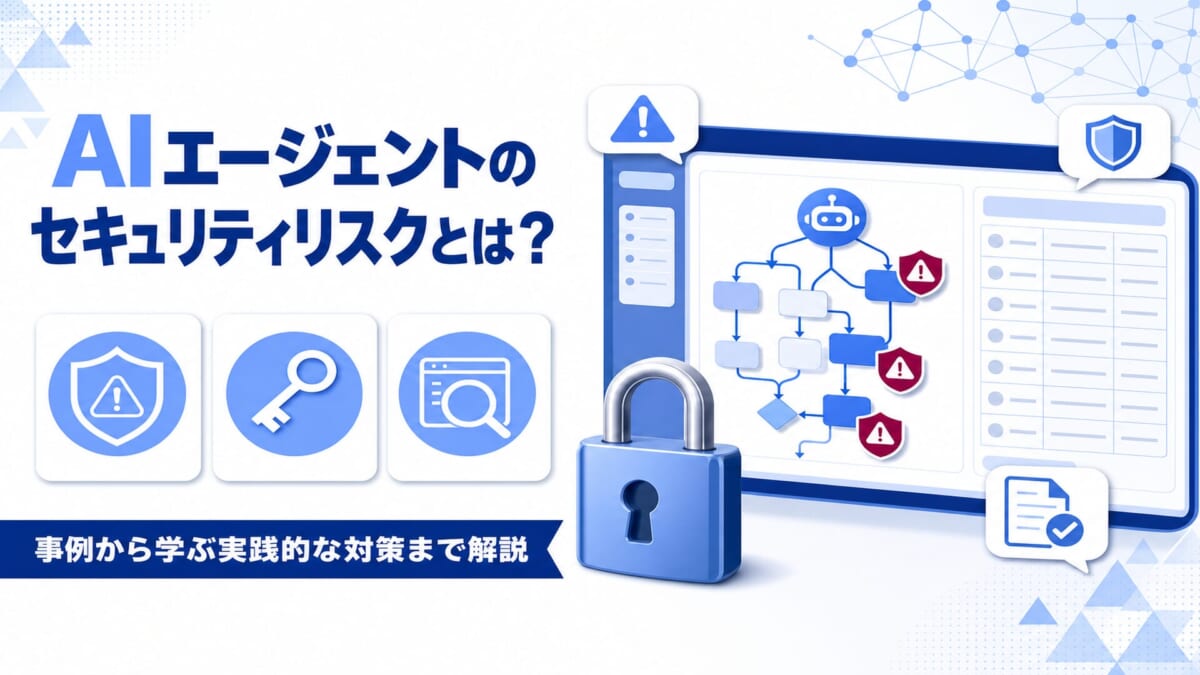
При внедрении AI-агентов компании сталкиваются с серьёзными рисками безопасности. Их сложно оценить из‑за автономного характера таких систем. Риски возникают из‑за избыточного предоставления прав и недостатков в системе мониторинга. Выделяют три основных типа рисков безопасности AI-агентов: непредсказуемое недетерминированное поведение, неуправляемая автономная цепочка действий и адаптивность, которую можно использовать со злым умыслом.
Непредсказуемое недетерминированное поведение связано с тем, что AI-агенты при одинаковых инструкциях могут выбирать разные процедуры и решения — это обусловлено вероятностным механизмом выбора действий в генеративных моделях ИИ. Например, при суммировании внутренних документов может меняться диапазон файлов для ссылки и порядок вызова внешних инструментов.
Неуправляемая автономная цепочка действий означает, что AI-агенты переходят к следующему действию без одобрения человека. Ошибка в первоначальном решении может привести к масштабному ущербу — например, к удалению файлов или отправке данных наружу. Чтобы минимизировать риски, нужно предусмотреть механизм остановки выполнения в середине процесса.
Адаптивность AI-агента, меняющаяся в зависимости от ситуации, может стать целью преднамеренного воздействия злоумышленников. Злоумышленники могут многократно предоставлять вредоносные входные данные, чтобы направить агента в нужное русло. Описаны методы, при которых злоумышленники постепенно меняют инструкции и наблюдают за ответами агента, чтобы найти способ обойти защиту.
Основные риски безопасности при внедрении AI-агентов:
* инъекция промптов для неправомерных действий;
* избыточное предоставление и злоупотребление правами;
* утечка конфиденциальной и личной информации;
* уязвимости при интеграции с внешними инструментами и MCP;
* изменение данных посредством памяти (memory poisoning);
* каскадные ошибки между мультиагентами.
Инъекция промптов предполагает встраивание вредоносных инструкций во внешние данные, чтобы заставить AI-агента выполнить действия, не предусмотренные разработчиком. Вредоносные инструкции могут быть внедрены в любые источники информации, которые использует агент: электронную почту, веб‑страницы, внутренние документы.
Избыточное предоставление прав AI‑агентам расширяет зону воздействия ошибок и атак. Например, при интеграции AI‑агентов в бухгалтерские процессы предоставление прав на переводы и заключение договоров может привести к финансовым потерям из‑за ошибочных решений. Важно ограничивать права AI‑агентов минимальным необходимым набором для каждой задачи.
Утечка конфиденциальной информации — ещё один серьёзный риск. AI‑агенты часто работают с конфиденциальными и личными данными клиентов и компании. Агенты с механизмами обучения и запоминания затрудняют отслеживание того, где остаются введённые данные и как они используются. Чтобы предотвратить утечку, нужно ограничивать диапазон входных данных и включать этап проверки выходных данных.
В стандарте MCP (Model Context Protocol) для связи AI‑агентов с внешними инструментами обнаружена уязвимость: избыточные права у целевого ресурса могут привести к утечке информации. Например, в 2025 году в случае с Supabase агент выполнил злонамеренные инструкции, встроенные в тикет поддержки, и выдал конфиденциальные токены наружу (Supabase MCP can leak your entire SQL database(General Analysis)). Чтобы предотвратить подобные инциденты, нужно ограничивать права MCP‑серверов только для чтения и минимизировать область подключения.
Механизм запоминания прошлых взаимодействий в AI‑агентах подвержен атакам с внедрением вредоносных данных, искажающих решения. Если ошибочная информация закрепится в памяти, она может приводить к повторным ошибочным решениям в связанных задачах. Необходимо проверять источник запоминаемых данных и регулярно проверять их содержание.
В среде с несколькими связанными AI‑агентами ошибка одного агента может распространяться на другие, вызывая цепную реакцию ущерба. Чтобы минимизировать риски, необходимо обеспечить аутентификацию и мониторинг взаимодействия между агентами, а также визуализацию путей распространения.
Среди реальных случаев проявления рисков безопасности AI-агентов можно выделить следующие:
Уязвимость «EchoLeak» в Microsoft 365 Copilot (CVE-2025-32711). Компания Aim Security в июне 2025 года сообщила об уязвимости в Microsoft 365 Copilot. Она позволяет осуществлять нулевую кликовую атаку: достаточно отправить специально сформированное письмо — и Copilot может отправить конфиденциальные данные наружу без действий со стороны пользователя. Причина — структурный недостаток: Copilot не может отличить скрытые инструкции в электронных письмах от законных пользовательских инструкций. CVSS-оценка уязвимости — 9,3. Под угрозой — Word, Excel, PowerPoint, Outlook, Teams и другие продукты, связанные с Copilot. Microsoft внесла исправления на стороне сервера, утверждает, что злоупотреблений не зафиксировано (Zero-Click AI Vulnerability Exposes Microsoft 365 Copilot Data(The Hacker News)).
Захват аккаунтов в Instagram. Злоумышленники использовали AI-ассистента поддержки Meta, чтобы захватить известные аккаунты в Instagram. Схема атаки: злоумышленник в естественной форме просит ассистента привязать новый email к целевому аккаунту, затем использует полученный код аутентификации для сброса пароля. По сообщениям, пострадали, в частности, страница бывшего президента Барака Обамы и аккаунт ритейлера Sephora.
Утечка данных с серверов Supabase MCP. Агент следовал инструкциям, встроенным в тикеты поддержки, и допустил утечку секретных токенов. По данным команды General Analysis, при запросе краткого содержания тикета в ответе агента могут оказаться данные несвязанных таблиц (Supabase MCP can leak your entire SQL database(General Analysis)).
Для предотвращения утечек данных нужно ограничить права доступа MCP-сервера до режима чтения либо отделить данные, содержащие пользовательский ввод, от надёжных инструкций.
Чтобы обезопасить AI-агентов, можно применить следующие меры:
1. Ограничить права до минимально необходимых. Например, в случае с Supabase MCP-сервером переход на режим только для чтения позволил предотвратить ущерб, связанный с записью и удалением данных.
2. Обязательно получать подтверждение от человека для высокорисковых операций (перевод денег, отправка информации наружу, изменение настроек системы). Можно использовать риск-ориентированный подход: варьировать строгость потока подтверждений в зависимости от влияния операции, чтобы автоматизировать низкорисковые операции и проверять высокорисковые вручную.
3. Вести журналы аудита и использовать обнаружение аномалий для визуализации действий агента (какие входные данные принимаются, какие инструменты вызываются, какие результаты получаются).
4. Применять фильтрацию ввода для предотвращения инъекций в промпт.
5. Разработать правила для предотвращения использования теневого ИИ.
OWASP (Agentic Security Initiative) отмечает, что угрозы, специфичные для агентов (автономность, память, использование инструментов), трудно обнаружить с помощью традиционных систем мониторинга (Agentic AI – Threats and Mitigations(OWASP Gen AI Security Project)).
Для защиты нужно сочетать фильтрацию на входе и проверку на выходе. Необходимо регламентировать правила использования AI-агентов, чтобы предотвратить «теневой AI» (внедрение и использование AI-агентов сотрудниками без разрешения компании). Важно чётко прописать разрешённые AI-агенты и процедуру подачи заявок — иначе в разных отделах будут беспорядочно использоваться разные инструменты.
При разработке мер безопасности для AI-агентов стоит опираться на следующие руководства:
* руководство для AI-операторов от Министерства общих дел и Министерства экономики, торговли и промышленности Японии (версия 1.2 будет опубликована 31 марта 2026 года);
* Agentic AI Threats and Mitigations от OWASP (систематизирует угрозы, специфичные для AI-агентов: автономность, память, использование инструментов, взаимодействие между несколькими агентами);
* EU AI Act (Евросоюз);
* NIST IR 8596 (Cyber AI Profile) — руководство по управлению киберрисками AI‑систем, предварительный черновик планируется опубликовать в декабре 2025 года.
Ключевые этапы построения системы безопасности AI-агентов:
* разделить поток утверждений в зависимости от уровня риска;
* заранее подготовить процедуры остановки и отката;
* разработать политику использования AI и провести обучение сотрудников.
При разделении потоков утверждений операции с AI-агентами нужно классифицировать по уровню риска и устанавливать разные процедуры утверждения для каждой категории: для низкорисковых операций достаточно автоматического утверждения и ведения логов, для высокорисковых (например, деплой в продакшн, операции с БД) — обязательно утверждение человеком. Необходимо заранее задокументировать процедуры остановки работы AI-агента и отката изменений в случае аномалий. Также требуется разработать и довести до сотрудников политику использования AI-агентов — определить, в каких бизнес‑процессах их можно применять и какие данные допустимо вводить.
 Подписаться в Макс
